Hermes Agent는 어떻게 스킬을 학습하는가?
Hermes Agent의 실제 코드를 따라가며 사용자의 대화 속 경험이 어떻게 재사용 가능한 SKILL.md가 되는지 분석.
Hermes를 사용하다 보면 한 번쯤 이런 질문이 생긴다.
“AI Agent가 스킬을 학습한다는데.
정말 모델이 다시 학습되는 걸까?”
먼저 결론부터 말하면 모델의 가중치가 바뀌는 것은 아니다.
Hermes는 작업 중 발견한 절차를 SKILL.md라는 Markdown 파일로 저장한다.
그리고 새로운 세션의 시스템 프롬프트에 스킬의 이름과 설명을 인덱스로 넣는다.
현재 요청과 관련된 스킬이 있으면 모델이 skill_view를 호출해 본문을 읽는다.
즉 Hermes의 학습은 파인튜닝이 아니다.
과거의 작업 경험을 미래 요청의 실행 컨텍스트로 다시 주입하는 구조다.
이번 글에서는 이 흐름을 설명 수준에서 끝내지 않는다.
실제 함수가 어떤 순서로 호출되는지.
카운터는 정확히 무엇을 세는지.
리뷰 에이전트는 어떤 권한으로 파일을 쓰는지.
그리고 생성된 스킬이 다음 세션에서 어떻게 다시 선택되는지를 코드 단위로 추적한다.
분석 기준은 2026년 8월 26일의
NousResearch/hermes-agent다.기준 커밋은
95668f5다.Code Link tests/tools/test_skill_manager_tool.py도 같은 소스에서 실행했으며 49개 테스트가 통과했다.
이 글의 핵심
Hermes가 학습 시점을 알아차리는 부분은 카운터와 턴 종료 조건으로 구현되어 있다.
대화에서 무엇을 배울지는 별도의 규칙 기반 Python 감지기가 아니라 리뷰 LLM이 판단한다.
저장은
skill_manage의 검증과 소유권 보호와 원자적 쓰기 과정을 통과해야 한다.저장된 스킬은 다음 시스템 프롬프트의 인덱스와
skill_view를 통해 다시 사용된다.
목차
1. Hermes에서 스킬은 무엇인가
2. 전체 호출 흐름은 어떻게 이어지는가
3. 학습 시점은 어떻게 계산되는가
4. 백그라운드 리뷰는 어떻게 격리되는가
5. 어떤 경험을 스킬로 판단하는가
6. skill_manage는 어떻게 파일을 생성하는가
7. 기존 스킬은 왜 읽은 뒤에만 수정할 수 있는가
8. 저장된 스킬은 어떻게 다시 선택되는가
9. 실제 예시를 끝까지 따라가 보기
10. 코드에서 발견한 오해하기 쉬운 지점
11. Curator는 이 흐름에서 무엇을 담당하는가
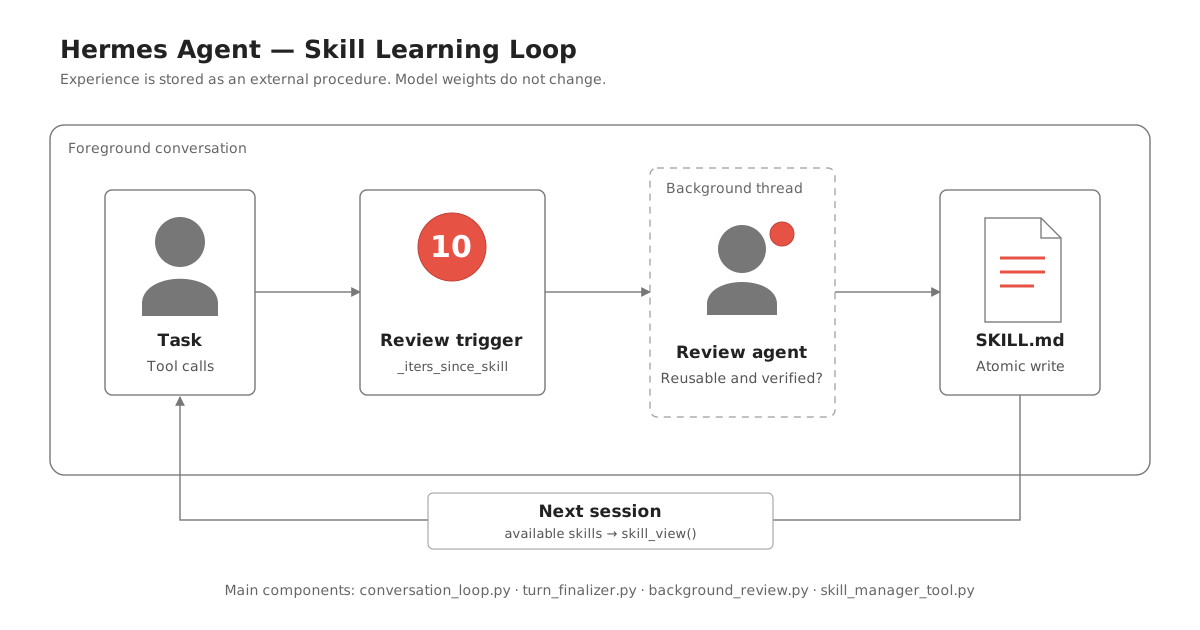 그림 1. 대화에서 발견한 작업 절차가 다음 세션의 실행 컨텍스트가 되는 과정
1. Hermes에서 스킬은 무엇인가?
Hermes 코드에서 스킬은 procedural memory로 설명된다.
한국어로 옮기면 절차 기억에 가깝다.
Memory와 Skill의 차이는 저장 대상에 있다.
| 구분 | 저장하는 내용 | 예시 |
|---|---|---|
| Memory | 계속 기억해야 하는 사실 | 사용자 선호와 프로젝트 상태 |
| Skill | 다시 사용할 수 있는 절차 | 설치와 디버깅과 검증 순서 |
파일 구조는 다음과 같다.
1
2
3
4
5
6
7
8
~/.hermes/skills/
└── <category>/
    └── <skill-name>/
        ├── SKILL.md
        ├── references/
        ├── templates/
        ├── scripts/
        └── assets/
SKILL.md는 미래의 에이전트가 읽을 실행 지침이다.
긴 자료는 references/에 둔다.
복사해서 수정할 골격은 templates/에 둔다.
결정적으로 다시 실행할 수 있는 작업은 scripts/에 둔다.
이미지와 정적 자료는 assets/에 둘 수 있다.
이 구분은 실제 skill_manage가 허용하는 하위 디렉터리 집합과 일치한다.
관련 상수는 Code Link tools/skill_manager_tool.py에 정의되어 있다.
여기서 중요한 점이 있다.
스킬은 새로운 능력을 모델 내부에 추가하지 않는다.
이미 모델이 가진 능력을 특정 작업 방식으로 유도하는 외부 지침이다.
2. 전체 호출 흐름은 어떻게 이어지는가?
코드 호출 흐름을 먼저 한 줄로 연결하면 다음과 같다.
1
2
3
4
5
6
7
8
9
10
11
12
13
AIAgent 초기화
  → 시스템 프롬프트에 스킬 지침과 스킬 인덱스 삽입
  → 모델 API 반복 호출
  → _iters_since_skill 증가
  → 턴 종료 시 임계값 검사
  → 대화 스냅샷 복사
  → bg-review 스레드 생성
  → 리뷰 전용 AIAgent 실행
  → skills_list / skill_view / skill_manage
  → SKILL.md 생성 또는 수정
  → 스킬 인덱스 캐시 무효화
  → 새로운 세션에서 스킬 인덱스 재구성
  → 관련 스킬을 skill_view로 로드
이 흐름에는 두 개의 학습 경로가 있다.
2.1 현재 작업 안에서 바로 저장하는 경로
메인 에이전트의 시스템 프롬프트에는 다음 행동 지침이 들어간다.
1
2
3
4
5
6
SKILLS_GUIDANCE = (
    "When you work out a non-trivial workflow, record it with skill_manage "
    "for future reuse.\n"
    "When using a skill and finding it outdated, incomplete, or wrong, "
    "patch it immediately with skill_manage(action='patch') ..."
)
실제 정의는 Code Link agent/prompt_builder.py - SKILLS_GUIDANCE에 있다.
이 지침은 skill_manage 도구가 현재 에이전트에서 활성화된 경우에만 들어간다.
주입 조건은 Code Link agent/system_prompt.py에서 확인할 수 있다.
따라서 메인 모델은 주기 임계값에 도달하기 전에도 스킬을 만들 수 있다.
이 경로는 현재 작업을 수행하던 모델이 skill_manage를 직접 호출하는 동기 경로다.
2.2 턴이 끝난 뒤 자동으로 검토하는 경로
별도의 카운터가 임계값에 도달하면 턴 종료 후 리뷰 에이전트가 실행된다.
이 경로는 현재 응답을 만든 모델과 학습 검토를 수행하는 에이전트를 분리한다.
사용자가 받는 응답은 먼저 완성된다.
스킬 리뷰는 이후 데몬 스레드에서 진행된다.
 그림 2. 메인 턴과 백그라운드 리뷰를 분리한 실제 호출 구조
3. 학습 시점은 어떻게 계산되는가?
이 부분이 기존 설명에서 가장 쉽게 부정확해지는 지점이다.
3.1 카운터의 초기값과 기본 임계값
에이전트가 만들어질 때 _iters_since_skill은 0으로 초기화된다.
리뷰 임계값인 _skill_nudge_interval의 기본값은 10이다.
1
2
3
4
5
6
7
agent._iters_since_skill = 0

agent._skill_nudge_interval = 10
skills_config = _agent_cfg.get("skills", {})
agent._skill_nudge_interval = int(
    skills_config.get("creation_nudge_interval", 10)
)
이 코드는 Code Link agent/agent_init.py - counter와 Code Link agent/agent_init.py - interval에 있다.
설정 키는 skills.creation_nudge_interval이다.
0 이하로 두면 자동 스킬 리뷰 트리거가 사실상 꺼진다.
3.2 카운터는 개별 도구 호출 수를 세지 않는다
일반 conversation loop는 모델 API를 한 번 호출하기 직전에 다음 코드를 실행한다.
1
2
3
4
5
6
7
api_call_count += 1

if (
    agent._skill_nudge_interval > 0
    and "skill_manage" in agent.valid_tool_names
):
    agent._iters_since_skill += 1
원본은 Code Link agent/conversation_loop.py에서 확인할 수 있다.
변수와 주석은 tool iteration이라고 표현한다.
하지만 현재 표준 루프의 실제 증가 위치는 개별 tool_calls를 순회하는 곳이 아니다.
모델 API 반복 호출 직전이다.
따라서 한 번의 모델 응답이 세 개의 도구를 병렬로 호출해도 이 지점의 증가는 한 번이다.
반대로 도구를 호출하지 않고 최종 답변만 반환하는 모델 호출도 이 지점을 이미 지난 뒤다.
코드 그대로 해석하면 카운터는 도구 개수보다 에이전트 루프의 모델 호출 횟수에 가깝다.
3.3 카운터는 턴이 바뀌어도 바로 초기화되지 않는다
새로운 사용자 턴이 시작될 때 iteration budget은 새로 만든다.
하지만 _iters_since_skill은 초기화하지 않는다.
1
2
# NOTE: _turns_since_memory and _iters_since_skill are NOT reset here.
agent.iteration_budget = IterationBudget(agent.max_iterations)
관련 코드는 Code Link agent/turn_context.py에 있다.
따라서 같은 AIAgent 인스턴스가 유지되는 동안 여러 사용자 턴의 값이 누적될 수 있다.
다만 이 값은 SKILL.md처럼 디스크에 저장되는 영속 상태가 아니다.
새 에이전트 인스턴스가 만들어지면 다시 0에서 시작한다.
3.4 skill_manage가 실제로 호출되면 0으로 돌아간다
도구 실행 파이프라인은 실행이 허용된 skill_manage 호출을 발견하면 카운터를 초기화한다.
1
2
3
4
if function_name == "memory":
    agent._turns_since_memory = 0
elif function_name == "skill_manage":
    agent._iters_since_skill = 0
원본은 Code Link agent/tool_executor.py에 있다.
여기에도 세부적인 동작이 하나 더 있다.
skill_manage 실행 뒤 최종 응답을 받기 위한 다음 모델 호출이 일어나면 카운터는 다시 1 증가할 수 있다.
따라서 “스킬을 저장했으니 턴 종료 시 항상 0이다”라고 이해하면 틀린다.
초기화 시점은 tool handler가 결과를 반환하기 전이다.
따라서 호출이 dispatcher까지 도달했다면 내용 검증이 실패하거나 write approval 단계에서 stage되더라도 카운터는 이미 0이 된 상태다.
3.5 임계값은 스킬 생성 조건이 아니라 리뷰 예약 조건이다
턴이 끝나면 finalizer가 누적값을 확인한다.
1
2
3
4
5
6
7
8
9
should_review_skills = False

if (
    agent._skill_nudge_interval > 0
    and agent._iters_since_skill >= agent._skill_nudge_interval
    and "skill_manage" in agent.valid_tool_names
):
    should_review_skills = True
    agent._iters_since_skill = 0
원본은 Code Link agent/turn_finalizer.py - threshold에 있다.
임계값을 넘겼다고 SKILL.md를 바로 만들지는 않는다.
여기서 만들어지는 것은 리뷰 실행 여부를 나타내는 Boolean 값이다.
실제 파일 생성 여부는 이후 리뷰 에이전트가 결정한다.
3.6 모든 종료 상황에서 리뷰가 실행되는 것은 아니다
리뷰가 실행되려면 다음 조건을 모두 만족해야 한다.
1
2
3
4
5
6
7
if (
    final_response
    and not interrupted
    and not agent.skip_background_review
    and (should_review_memory or should_review_skills)
):
    agent._spawn_background_review(...)
원본은 Code Link agent/turn_finalizer.py - review dispatch에 있다.
최종 응답이 없으면 실행하지 않는다.
중단된 턴에서도 실행하지 않는다.
cron처럼 skip_background_review=True인 실행에서도 건너뛴다.
그리고 이 호출 전체는 best effort로 감싸져 있다.
리뷰 시작에 실패해도 사용자의 본 요청 응답은 그대로 반환한다.
3.7 숫자로 따라가 보면 더 명확하다
기본 임계값을 10이라고 가정해 보자.
| 시점 | _iters_since_skill | 의미 |
|---|---|---|
| 에이전트 생성 | 0 | 초기값 |
| 첫 번째 모델 호출 | 1 | 도구 수가 아니라 루프 1회 |
| 다음 턴 시작 | 유지 | 턴 경계에서 초기화하지 않음 |
| 누적 열 번째 모델 호출 | 10 | 리뷰 임계값 도달 |
| 정상 응답 종료 | 0 | 리뷰 예약 후 finalizer가 초기화 |
| 백그라운드 검토 | 별도 에이전트 | 저장 여부를 새로 판단 |
이 표에서 가장 중요한 행은 마지막 두 행이다.
10은 스킬 생성 횟수가 아니다.
리뷰 에이전트에게 대화를 한 번 살펴보라고 요청하는 주기다.
 그림 3. 카운터는 모델 API 루프에서 증가하고 skill_manage dispatch와 리뷰 예약에서 초기화된다
4. 백그라운드 리뷰는 어떻게 격리되는가?
4.1 메인 응답이 끝난 뒤 데몬 스레드를 만든다
_spawn_background_review는 리뷰 실행 함수를 준비한 뒤 bg-review라는 데몬 스레드를 시작한다.
1
2
3
4
5
6
7
8
9
target, prompt = spawn_background_review_thread(...)

thread = threading.Thread(
    target=propagate_context_to_thread(target),
    daemon=True,
    name="bg-review",
)

thread.start()
원본은 Code Link run_agent.py에 있다.
프로필 컨텍스트도 새 스레드로 전달한다.
그래야 리뷰 결과가 다른 프로필의 skills/에 저장되지 않는다.
4.2 리뷰가 중복으로 실행되지 않도록 막는다
prepare_background_review_run은 현재 완료되지 않은 리뷰가 있으면 새 리뷰를 만들지 않는다.
새로운 실시간 사용자 턴이 시작되면 진행 중인 리뷰에 취소 신호도 보낼 수 있다.
취소 확인 대기는 최대 2초로 제한한다.
리뷰가 늦더라도 본 사용자 턴을 무기한 막지 않기 위한 설계다.
이 동시성 제어는 Code Link agent/background_review.py - thread control에 구현되어 있다.
4.3 리뷰 전용 AIAgent를 새로 만든다
백그라운드 스레드 안에서는 부모 에이전트를 그대로 재사용하지 않는다.
리뷰용 AIAgent를 새로 만든다.
리뷰 에이전트의 최대 iteration은 현재 코드에서 16으로 고정되어 있다.
기본값은 부모의 모델과 provider와 인증 정보를 이어받는 것이다.
같은 모델을 사용하면 부모의 cached system prompt도 공유해 provider prefix cache를 재사용한다.
별도 보조 모델을 설정했다면 그 모델의 runtime을 사용한다.
이 경우 캐시가 차갑기 때문에 전체 대화 대신 digest를 전달한다.
iteration 상수는 Code Link agent/background_review.py - review constants에 있다.
runtime 분기는 Code Link agent/background_review.py - runtime fork와 Code Link agent/background_review.py - tool restriction에 있다.
4.4 리뷰 에이전트의 권한은 의도적으로 좁다
리뷰 fork에 적용되는 핵심 제약은 다음과 같다.
| 항목 | 동작 |
|---|---|
| 외부 memory provider | skip_memory=True로 부작용 차단 |
| 자체 리뷰 재귀 | memory와 skill nudge interval을 0으로 설정 |
| 세션 DB | _persist_disabled=True로 쓰기 차단 |
| JSON 세션 저장 | 비활성화 |
| 도구 | memory와 skills toolset만 whitelist |
| 위험 명령 승인 | 비대화형 auto deny |
세션 DB 쓰기를 막는 이유는 특히 중요하다.
리뷰 프롬프트와 리뷰 답변이 실제 사용자 세션의 메시지로 저장되면 안 된다.
그 메시지를 다음 사용자 턴에서 다시 읽으면 메인 에이전트가 리뷰 지시를 현재 사용자 요청처럼 오해할 수 있다.
실제 격리 설정은 Code Link agent/background_review.py - isolation에 있다.
도구 whitelist는 Code Link agent/background_review.py - whitelist에 있다.
즉 리뷰 에이전트는 과거 대화를 볼 수 있다.
하지만 터미널이나 브라우저를 사용해 새로운 일을 벌일 수는 없다.
 그림 4. 리뷰 fork가 부모에게서 이어받는 runtime과 차단되는 persistence 및 tool surface
5. 어떤 경험을 스킬로 판단하는가?
여기서 가장 먼저 바로잡아야 할 오해가 있다.
Hermes에는 “사용자가 형식을 지적하면 스킬 생성” 같은 Python if 문이 없다.
카운터와 finalizer는 언제 검토할지만 결정한다.
대화 내용에서 학습 신호를 찾는 일은 _SKILL_REVIEW_PROMPT를 받은 LLM이 수행한다.
즉 구조는 다음과 같다.
1
2
3
4
5
6
7
8
결정적 Python 로직
  → 리뷰 실행 시점 결정

비결정적 LLM 판단
  → 무엇을 저장할지 결정

결정적 Python 로직
  → 쓰기 권한과 파일 형식 검증
리뷰 프롬프트 원문은 Code Link agent/background_review.py - _SKILL_REVIEW_PROMPT에 있다.
5.1 저장 후보로 보는 신호
리뷰 프롬프트는 다음을 학습 신호로 지정한다.
사용자가 말투와 형식과 가독성과 장황함을 교정한 경우.
사용자가 작업 방식이나 단계 순서를 교정한 경우.
비자명한 해결책과 우회법과 디버깅 경로가 실제로 나온 경우.
이번 대화에서 읽은 기존 스킬이 틀렸거나 단계가 빠진 경우.
중요한 점은 사용자 스타일 교정을 단순 Memory 신호로만 보지 않는다는 것이다.
특정 종류의 작업을 어떻게 수행해야 하는지에 관한 선호라면 관련 스킬 본문에도 넣도록 지시한다.
5.2 새 스킬 생성은 마지막 선택이다
리뷰 에이전트의 우선순위는 다음과 같다.
이번 세션에서 실제로 읽은 curator 관리 스킬을 수정한다.
같은 문제군을 다루는 기존 umbrella skill을 찾는다.
기존 umbrella 아래에 reference와 template과 script를 추가한다.
어느 것에도 들어맞지 않을 때만 class-level 새 스킬을 만든다.
따라서 fix-error-1234 같은 이름은 피해야 한다.
python-package-troubleshooting처럼 문제의 종류를 표현해야 한다.
이 정책은 스킬 수가 세션 수만큼 늘어나는 것을 막는다.
5.3 저장하지 말아야 할 내용도 명시한다
다음 내용은 스킬로 만들지 않도록 지시한다.
설치되지 않은 바이너리와 자격 증명처럼 바뀔 수 있는 환경 상태.
잠시 실패했지만 재시도로 사라진 오류 그 자체.
특정 PR 번호와 오늘의 작업에만 맞는 일회성 서사.
끝내 해결하지 못한 시도들의 나열.
실패를 저장할 때도 “도구가 동작하지 않는다”라는 영구적 부정 명제를 만들면 안 된다.
검증된 설치 단계나 재시도 패턴이 있다면 그 해결 절차만 저장한다.
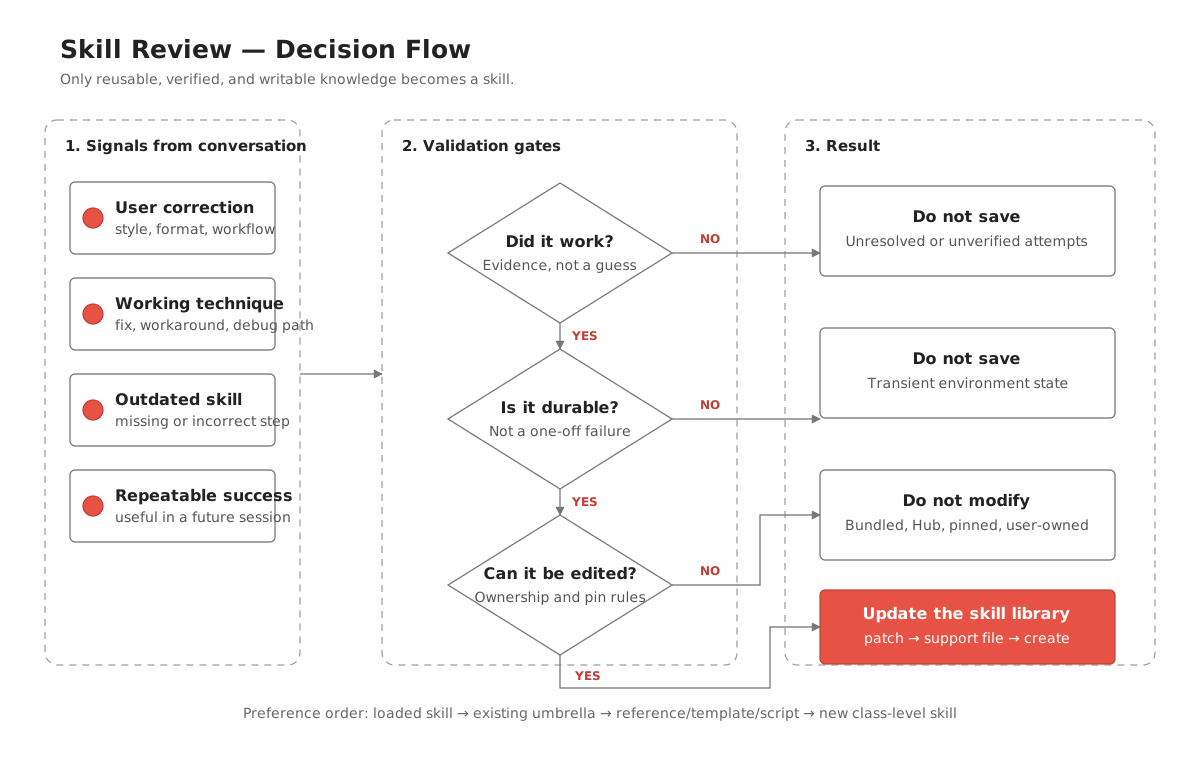 그림 5. 카운터가 리뷰를 열고 LLM이 지속성과 재사용성과 검증 여부를 판단한다
5.4 프롬프트의 적극성과 코드의 보호 규칙은 서로 견제한다
리뷰 프롬프트는 대부분의 세션에서 작은 업데이트라도 찾으라고 적극적으로 지시한다.
그렇다고 모델이 모든 스킬을 자유롭게 수정할 수 있는 것은 아니다.
다음 스킬은 백그라운드 리뷰가 수정할 수 없다.
bundled skill.
Skills Hub에서 설치한 skill.
skills.external_dirs에 있는 skill.pinned skill.
curator 관리 대상으로 명시되지 않은 user-owned skill.
이 보호 규칙은 프롬프트 문구에만 의존하지 않는다.
_background_review_write_guard가 실제 도구 호출을 거부한다.
관련 구현은 Code Link tools/skill_manager_tool.py - ownership guard에 있다.
6. skill_manage는 어떻게 파일을 생성하는가?
리뷰 LLM이 저장할 가치가 있다고 판단하면 다음과 같은 도구 호출을 만든다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
skill_manage(
    action="create",
    name="technical-architecture-diagrams",
    category="writing",
    content="""---
name: technical-architecture-diagrams
description: 코드 근거로 기술 흐름도를 작성할 때 사용한다.
---

# Technical architecture diagrams

## Workflow

1. Trace the real entry point and state transitions.
2. Separate deterministic code from LLM decisions.
3. Draw only verified components.
4. Check overlap and clipping before export.
""",
)
이 호출은 단순히 open(...).write(...)로 이어지지 않는다.
여러 단계의 검증과 기록을 통과한다.
6.1 쓰기 주체를 ContextVar로 구분한다
일반 에이전트의 write origin은 foreground 계열 값이다.
백그라운드 리뷰 에이전트는 _memory_write_origin="background_review"를 가진다.
턴 시작 시 이 값이 ContextVar에 바인딩된다.
1
2
3
set_current_write_origin(
    getattr(agent, "_memory_write_origin", "assistant_tool")
)
관련 코드는 Code Link agent/turn_context.py와 Code Link tools/skill_provenance.py에 있다.
이 구분은 나중에 자동 관리 권한을 정하는 데 사용된다.
6.2 skill_manage 진입점에서 preflight를 수행한다
skill_manage의 시작 부분은 대략 다음 순서다.
1
2
3
4
background review 소유권 preflight
  → write approval gate
  → 변경 전 audit snapshot
  → action별 handler dispatch
승인 gate가 꺼져 있으면 실제 쓰기로 진행한다.
승인 gate가 켜져 있으면 큰 스킬 내용을 즉시 쓰지 않고 pending write로 stage할 수 있다.
승인된 pending write는 gate를 우회하는 ContextVar를 설정한 뒤 같은 skill_manage를 다시 호출한다.
구현은 Code Link tools/skill_manager_tool.py - validation에 있다.
6.3 이름과 category와 frontmatter를 검증한다
새 스킬 생성은 다음 조건을 확인한다.
| 검사 | 현재 코드의 조건 |
|---|---|
| name | 최대 64자 |
| name 문자 | 소문자와 숫자와 .와 _와 - |
| category | 단일 디렉터리 이름 |
| frontmatter | name과 description 필수 |
| 새 description | 시스템 프롬프트 예산 60자 이하 |
| 본문 | frontmatter 뒤에 비어 있지 않은 내용 필요 |
| SKILL.md 크기 | 최대 100,000자 |
| 지원 파일 | 최대 100,000자와 1 MiB 제한을 모두 적용하며 허용된 하위 폴더만 가능 |
새 description을 60자로 제한하는 이유도 코드에 적혀 있다.
시스템 프롬프트의 스킬 인덱스에서 description이 잘리면 모델이 언제 그 스킬을 선택해야 하는지 알기 어려워지기 때문이다.
검증 함수는 Code Link tools/skill_manager_tool.py - frontmatter validation에 있다.
6.4 이름 충돌을 확인하고 원자적으로 기록한다
_create_skill은 local skills directory와 external directory를 검색해 같은 이름이 있는지 확인한다.
충돌이 없으면 category와 name으로 디렉터리를 만든다.
이후 atomic_write_text로 SKILL.md를 기록한다.
1
2
3
4
5
6
7
8
9
10
skill_dir = _resolve_skill_dir(name, category)
skill_dir.mkdir(parents=True, exist_ok=True)

skill_md = skill_dir / "SKILL.md"
atomic_write_text(
    skill_md,
    content,
    preserve_mode=True,
    create_mode=0o644,
)
전체 생성 함수는 Code Link tools/skill_manager_tool.py - _create_skill에 있다.
원자적 쓰기를 사용하므로 다른 reader가 절반만 기록된 SKILL.md를 볼 가능성을 줄인다.
6.5 security scan은 hook이지만 기본값은 비활성화다
파일을 쓴 뒤 _security_scan_skill을 호출한다.
검사 결과가 block이면 생성한 디렉터리를 지운다.
기존 파일의 edit나 patch였다면 원본 내용을 다시 원자적으로 기록한다.
하지만 정확히 짚고 넘어갈 부분이 있다.
에이전트가 만든 스킬에 대한 이 검사는 skills.guard_agent_created가 켜져 있을 때만 실행된다.
현재 기본값은 False다.
따라서 “모든 자동 생성 스킬이 항상 보안 스캐너를 통과한다”라고 쓰면 틀리다.
정확한 표현은 “보안 검사 hook이 있으며 설정으로 활성화하면 차단 시 rollback한다”다.
구현과 기본값은 Code Link tools/skill_manager_tool.py - security scan에 있다.
6.6 성공 뒤에는 파일 외의 상태도 바뀐다
skill_manage는 성공한 쓰기 뒤 다음 후처리를 실행한다.
1
2
3
4
5
append-only audit ledger 기록
  → skills system prompt의 메모리 캐시 제거
  → disk snapshot 제거
  → usage와 provenance 기록
  → 선택적으로 skill sync push 예약
백그라운드 리뷰가 새 스킬을 만들면 record_created(..., agent_created=True)가 호출된다.
이때 .usage.json 레코드에 created_by: agent가 들어간다.
현재 코드에서 이 값은 단순한 저자 표시보다 curator 관리에 동의한 정책 플래그로 사용된다.
반대로 foreground에서 사용자의 요청으로 만든 스킬은 agent_created=False다.
그 스킬은 사용자 소유로 남고 자동 리뷰가 수정하지 못한다.
후처리 구현은 Code Link tools/skill_manager_tool.py - post write에 있다.
관리 플래그의 의미는 Code Link tools/skill_usage.py에서 확인할 수 있다.
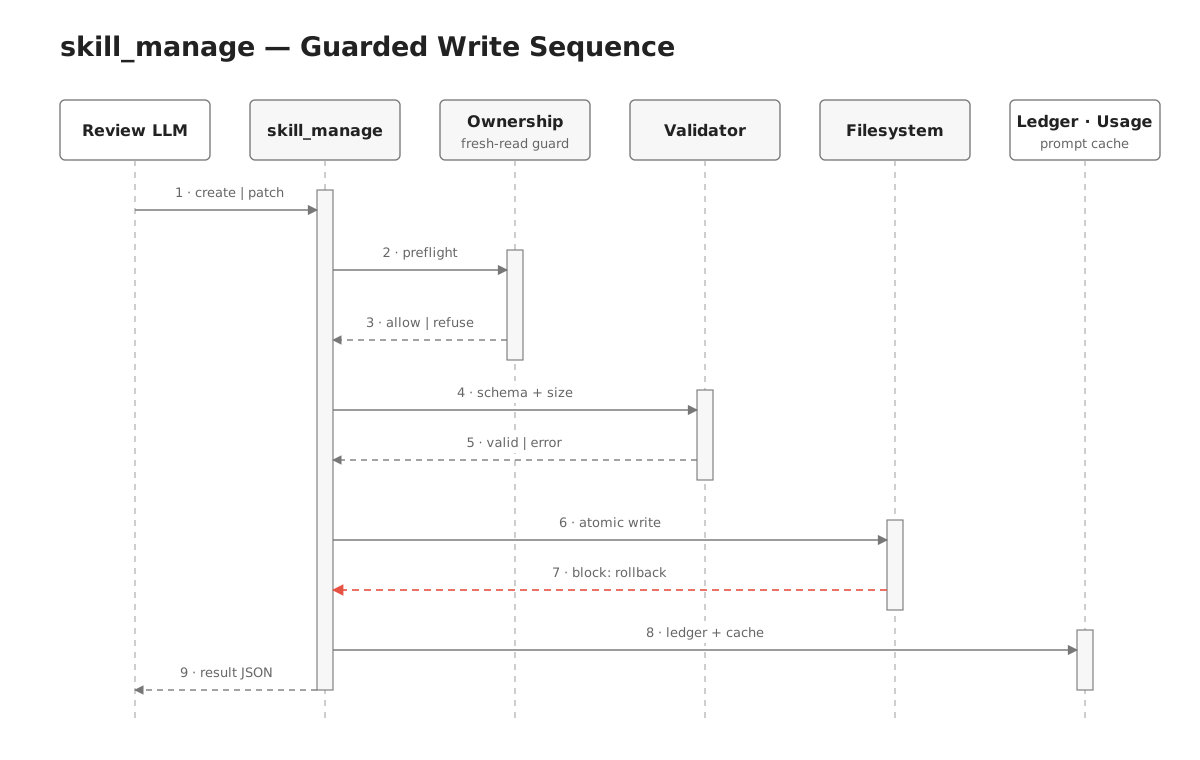 그림 6. LLM의 create 또는 patch 요청이 소유권과 검증과 원자적 쓰기와 후처리를 통과하는 순서
7. 기존 스킬은 왜 읽은 뒤에만 수정할 수 있는가?
새 스킬 생성과 기존 스킬 수정은 권한이 다르다.
백그라운드 리뷰는 새 스킬을 만들 때 사전 읽기가 필요하지 않다.
하지만 기존 파일을 patch하거나 edit하려면 같은 리뷰 실행 안에서 대상 파일을 먼저 읽어야 한다.
이것이 read-before-write 규칙이다.
7.1 skill_view가 읽은 경로를 기록한다
리뷰 에이전트가 skill_view(name)를 호출하면 실제 SKILL.md 경로가 ContextVar 기반 read set에 들어간다.
지원 파일을 읽으면 그 파일의 정확한 경로가 들어간다.
1
mark_background_review_skill_read(skill_md)
SKILL.md read mark는 Code Link tools/skills_tool.py - SKILL.md read mark에 있다.
지원 파일 read mark는 Code Link tools/skills_tool.py - linked file read mark에 있다.
7.2 patch는 동일한 경로의 read mark를 검사한다
_patch_skill은 수정할 실제 target을 구한 뒤 read guard를 호출한다.
1
2
3
4
5
6
read_guard = _background_review_read_before_write_guard(
    name,
    target,
    "patch",
    "SKILL.md" if not file_path else file_path,
)
read mark가 없다면 도구는 실패 JSON을 반환한다.
대화 기록 안에 과거 SKILL.md 내용이 보이더라도 인정하지 않는다.
현재 리뷰 실행에서 skill_view로 새로 읽은 내용만 인정한다.
guard 구현은 Code Link tools/skill_manager_tool.py - fresh-read guard에 있다.
patch 구현은 Code Link tools/skill_manager_tool.py - patch에 있다.
7.3 patch는 단순 exact replace보다 조금 더 강하다
_patch_skill은 fuzzy_find_and_replace를 사용한다.
공백과 들여쓰기 차이 같은 작은 불일치를 처리할 수 있다.
match가 없으면 파일 앞부분을 preview로 돌려줘 모델이 한 번 수정할 수 있게 한다.
SKILL.md를 patch했다면 변경 뒤 frontmatter가 여전히 유효한지도 다시 검사한다.
쓰기 뒤 보안 검사가 차단하면 원본을 복원한다.
즉 기존 스킬 수정의 핵심 순서는 다음과 같다.
1
2
3
4
5
6
7
8
skill_view로 최신 내용 읽기
  → exact target read mark 생성
  → curator 소유권 확인
  → fuzzy patch 계산
  → 크기와 frontmatter 재검증
  → atomic write
  → 선택적 security scan
  → 실패 시 rollback
8. 저장된 스킬은 어떻게 다시 선택되는가?
저장만 하고 끝나면 학습 루프가 아니다.
새로운 에이전트가 스킬의 존재를 알아야 한다.
8.1 prompt builder가 스킬 인덱스를 만든다
build_skills_system_prompt는 모든 SKILL.md의 frontmatter를 읽는다.
그리고 category별로 name과 description을 정리한다.
출력 형태는 다음과 비슷하다.
1
2
3
4
<available_skills>
  writing:
    - technical-architecture-diagrams: 코드 근거로 기술 흐름도를 작성할 때 사용한다.
</available_skills>
시스템 프롬프트는 관련성이 조금이라도 있으면 skill_view(name)로 스킬을 읽도록 강하게 지시한다.
관련 렌더링 코드는 Code Link agent/prompt_builder.py - skill index에 있다.
여기서 description은 단순 소개가 아니다.
모델이 스킬을 선택하는 routing signal이다.
그래서 새 스킬의 description을 60자로 제한하고 trigger를 앞에 쓰도록 검증한다.
8.2 인덱스는 두 단계로 캐시된다
스킬 인덱스는 매 요청마다 전체 디렉터리를 읽지 않는다.
프로세스 내부 LRU cache를 먼저 사용한다.
그다음 .skills_prompt_snapshot.json disk snapshot을 사용한다.
snapshot에는 SKILL.md와 DESCRIPTION.md의 mtime과 size manifest가 들어간다.
manifest가 현재 파일과 다를 때만 전체 scan으로 돌아간다.
관련 코드는 Code Link agent/prompt_builder.py - skill cache에 있다.
skill_manage가 성공하면 두 캐시를 모두 무효화한다.
따라서 새로운 세션이나 시스템 프롬프트 재구성 시 새 스킬을 포함한 인덱스를 만든다.
8.3 현재 세션의 system prompt가 즉시 교체되는 것은 아니다
이 부분도 중요하다.
skill_manage가 비우는 것은 스킬 인덱스 builder의 cache다.
이미 현재 에이전트에 저장된 _cached_system_prompt 자체를 즉시 None으로 만들지는 않는다.
Hermes의 system prompt는 세션 동안 prefix cache 안정성을 위해 유지된다.
context compression이나 restore 과정에서 다시 만들어질 때 최신 스킬 인덱스를 읽는다.
관련 설명은 Code Link agent/system_prompt.py - prompt cache와 Code Link agent/system_prompt.py - rebuild에 있다.
같은 세션은 방금 실행한 skill_manage의 tool result와 대화 이력을 통해 새 스킬을 알고 있다.
새로운 세션은 다시 만들어진 인덱스를 통해 그 스킬을 발견한다.
8.4 skill_view가 전체 내용을 불러온다
모델은 인덱스에서 관련 스킬을 찾으면 skill_view(name)를 호출한다.
skill_view는 이름과 경로를 검증한다.
platform 조건과 disabled 상태도 확인한다.
본문과 description과 linked files와 setup 상태를 JSON으로 돌려준다.
지원 파일이 필요하면 skill_view(name, file_path="references/...")를 다시 호출한다.
경로에 ..가 있거나 skill directory 밖으로 나가면 거부한다.
진입점은 Code Link tools/skills_tool.py - skill_view에 있다.
지원 파일 경로 검증은 Code Link tools/skills_tool.py - path validation에 있다.
성공한 skill_view는 view_count와 use_count도 올린다.
같은 task에서 변경되지 않은 파일을 다시 읽으면 mtime과 size를 비교해 전체 본문 대신 dedup 안내만 반환할 수 있다.
context compression 뒤에는 dedup cache를 비워 전체 내용을 다시 받을 수 있게 한다.
이 동작은 Code Link tools/skills_tool.py - index invalidation에 있다.
 그림 7. 작은 routing index와 전체 SKILL.md를 분리하고 쓰기 뒤 cache를 갱신하는 경로
9. 실제 예시를 끝까지 따라가 보기
이제 사용자가 기술 흐름도 작성 결과를 보고 다음과 같이 교정했다고 가정해 보자.
“구성 요소가 겹치고 글자가 잘린다.
실제 코드에 있는 흐름만 남겨라.
Pretendard를 사용하고 부연 설명은 가운데 정렬하라.”
9.1 메인 에이전트가 작업을 수정한다
메인 에이전트는 현재 요청을 수행한다.
이 과정에서 코드 검색과 파일 읽기와 이미지 검증을 위해 여러 번 모델 루프를 돌 수 있다.
카운터가 이전 턴까지 7이었다고 가정하자.
이번 턴에 모델 API 반복이 세 번 일어나면 값은 10이 된다.
도구를 몇 개 호출했는지가 아니라 표준 conversation loop의 API 반복 횟수가 기준이다.
9.2 finalizer가 리뷰를 예약한다
최종 응답이 있고 중단되지 않았다면 _should_review_skills=True가 된다.
카운터는 0으로 돌아간다.
최종 응답이 확정된 finalizer 단계에서 대화 메시지 목록의 shallow copy를 리뷰 spawn 함수에 넘긴다.
리뷰는 데몬 스레드이므로 finalizer가 리뷰 완료까지 기다리지는 않는다.
9.3 리뷰 LLM이 의미를 판단한다
리뷰 프롬프트 관점에서 이 대화에는 두 신호가 있다.
첫 번째는 형식과 가독성에 대한 사용자 교정이다.
두 번째는 실제 코드 근거만 사용하라는 workflow 교정이다.
리뷰 에이전트는 먼저 skills_list와 skill_view로 기존 umbrella skill을 찾는다.
적절한 curator 관리 스킬이 있으면 새 스킬을 만들지 않고 patch한다.
적절한 스킬이 없다면 technical-architecture-diagrams처럼 문제 클래스를 나타내는 새 스킬을 만들 수 있다.
9.4 skill_manage(create)가 검증을 수행한다
앞에서 본 예시 payload가 들어오면 다음 순서로 처리한다.
1
2
3
4
5
6
7
8
9
10
11
name이 허용 문자와 64자 제한을 만족하는가
  → category가 단일 디렉터리인가
  → YAML frontmatter에 name과 description이 있는가
  → description이 60자 이하인가
  → body가 존재하는가
  → 같은 이름의 스킬이 없는가
  → ~/.hermes/skills/writing/technical-architecture-diagrams 생성
  → SKILL.md atomic write
  → 설정이 켜졌다면 security scan
  → created_by: agent 기록
  → 스킬 인덱스 cache 삭제
성공 결과는 다음과 같은 형태다.
1
2
3
4
5
6
{
  "success": true,
  "message": "Skill 'technical-architecture-diagrams' created.",
  "path": "writing/technical-architecture-diagrams",
  "skill_md": "~/.hermes/skills/writing/technical-architecture-diagrams/SKILL.md"
}
실제 skill_md 값에는 축약된 ~가 아니라 실행 환경의 절대 경로가 들어간다.
9.5 다음 세션이 스킬을 다시 읽는다
다음에 사용자가 “Hermes의 세션 복구 아키텍처를 그림으로 정리해 줘”라고 요청했다고 하자.
새 에이전트의 시스템 프롬프트에는 다음 인덱스가 들어간다.
1
- technical-architecture-diagrams: 코드 근거로 기술 흐름도를 작성할 때 사용한다.
모델은 요청과 description이 관련 있다고 보고 다음 도구를 호출한다.
1
skill_view(name="technical-architecture-diagrams")
이제 모델은 이전 대화의 문장을 그대로 기억하는 것이 아니다.
이전에 검증한 작업 절차를 현재 요청의 실행 규칙으로 다시 읽는다.
이 지점에서 학습 루프가 완성된다.
1
2
3
4
5
6
과거 대화의 교정
  → 리뷰 LLM의 의미 판단
  → SKILL.md
  → 다음 시스템 프롬프트의 name과 description
  → skill_view
  → 현재 작업의 실행 절차
10. 코드에서 발견한 오해하기 쉬운 지점
10.1 “10번 도구 호출하면 스킬을 만든다”는 설명은 정확하지 않다
기본값 10은 자동 리뷰 주기다.
표준 conversation loop에서는 개별 도구 수가 아니라 모델 API 반복 지점에서 카운터를 올린다.
그리고 임계값 도달 뒤에도 리뷰 LLM이 Nothing to save.를 선택할 수 있다.
10.2 학습 신호를 찾는 별도 분류 모델은 없다
Python은 실행 주기와 권한을 결정한다.
대화가 저장할 가치가 있는지는 _SKILL_REVIEW_PROMPT를 받은 LLM이 판단한다.
따라서 같은 대화라도 모델과 설정에 따라 세부 판단이 달라질 수 있다.
10.3 foreground 생성 스킬과 background 생성 스킬은 소유권이 다르다
사용자가 현재 대화에서 직접 만들어 달라고 한 스킬은 사용자 소유다.
자동 리뷰가 만든 스킬은 created_by: agent로 기록되어 curator 관리 대상이 된다.
파일 형식은 같아도 자동 수정 권한은 다르다.
10.4 read-before-write는 프롬프트 권고가 아니라 도구 guard다
리뷰 에이전트가 기존 스킬을 읽지 않고 patch하면 실제 tool이 거부한다.
대화 기록에서 본 예전 내용은 fresh read로 인정하지 않는다.
10.5 security scan은 기본적으로 항상 실행되는 것이 아니다
hook 호출은 항상 지나간다.
실제 scan은 skills.guard_agent_created가 활성화된 경우에 수행된다.
기본값은 꺼져 있다.
10.6 새 스킬이 현재 system prompt에 즉시 끼어드는 것은 아니다
스킬 인덱스 cache는 쓰기 직후 무효화된다.
하지만 이미 고정된 현재 세션의 _cached_system_prompt는 다음 compression이나 rebuild까지 유지될 수 있다.
새 세션에서는 최신 인덱스를 통해 정상적으로 발견된다.
10.7 Codex app-server 경로는 카운터를 별도로 보정한다
Hermes가 Codex app-server runtime을 사용할 때는 일반 chat completions loop를 우회한다.
이 경로는 반환된 turn.tool_iterations를 _iters_since_skill에 더한다.
이후 같은 임계값 조건을 검사한다.
관련 코드는 Code Link agent/codex_runtime.py에 있다.
즉 provider runtime이 달라도 동일한 리뷰 루프를 유지하려고 하지만 카운터의 원천은 경로별로 다르다.
11. Curator는 이 흐름에서 무엇을 담당하는가?
background review와 Curator는 역할이 다르다.
background review는 방금 끝난 대화에서 새 절차를 찾는다.
Curator는 이미 존재하는 스킬의 장기 생명주기를 관리한다.
기본값은 다음과 같다.
| 설정 | 기본값 |
|---|---|
| 실행 간격 | 7일 |
| 최소 idle 시간 | 2시간 |
| stale 전환 | 30일 |
| archive 전환 | 90일 |
| LLM consolidation | 꺼짐 |
시간 기반 stale와 archive 전이는 결정적 코드로 실행된다.
LLM이 umbrella skill을 만드는 consolidation은 기본적으로 꺼져 있다.
기본값은 Code Link agent/curator.py에서 확인할 수 있다.
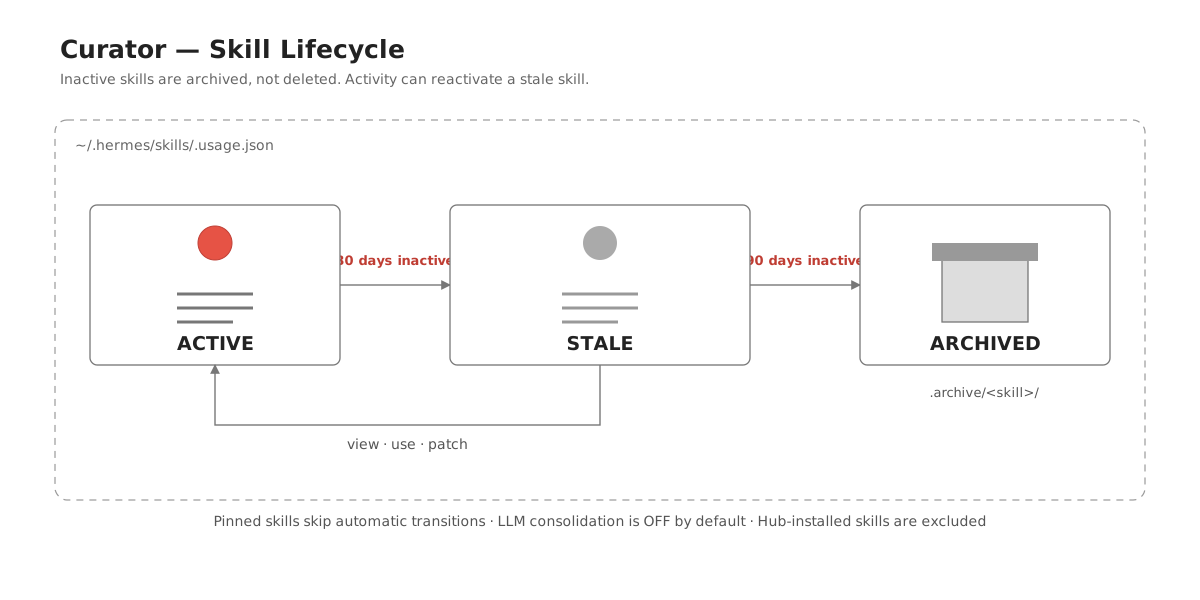 그림 8. Curator의 장기 lifecycle 전이
결론
Hermes의 스킬 학습은 하나의 마법 같은 함수가 아니다.
세 부분을 결합한 시스템이다.
첫 번째는 카운터와 finalizer로 구성된 결정적 스케줄러다.
두 번째는 대화의 의미를 읽고 저장 대상을 선택하는 리뷰 LLM이다.
세 번째는 소유권과 read-before-write와 파일 형식을 강제하는 결정적 쓰기 도구다.
그리고 다음 세션의 prompt builder와 skill_view가 저장된 절차를 다시 현재 작업에 연결한다.
한 문장으로 정리하면 다음과 같다.
Hermes는 모델의 가중치를 다시 학습하지 않는다.
검증된 작업 경험을 읽을 수 있는 절차로 저장하고 다음 세션의 행동 규칙으로 다시 불러온다.
이 구조의 장점은 투명성이다.
무엇을 배웠는지 파일로 확인할 수 있다.
잘못된 내용은 patch하거나 archive할 수 있다.
반면 한계도 분명하다.
무엇이 재사용 가능한 경험인지 판단하는 주체는 여전히 LLM이다.
그래서 Hermes는 LLM의 판단 앞뒤에 결정적인 스케줄링과 권한 검사를 배치한다.
Hermes의 self-improvement는 자유로운 자기 수정이 아니다.
제한된 쓰기 권한 안에서 경험을 절차화하고 재주입하는 피드백 루프다.